Le filigrane textuel de Claude, bonne ou fausse bonne idée ?
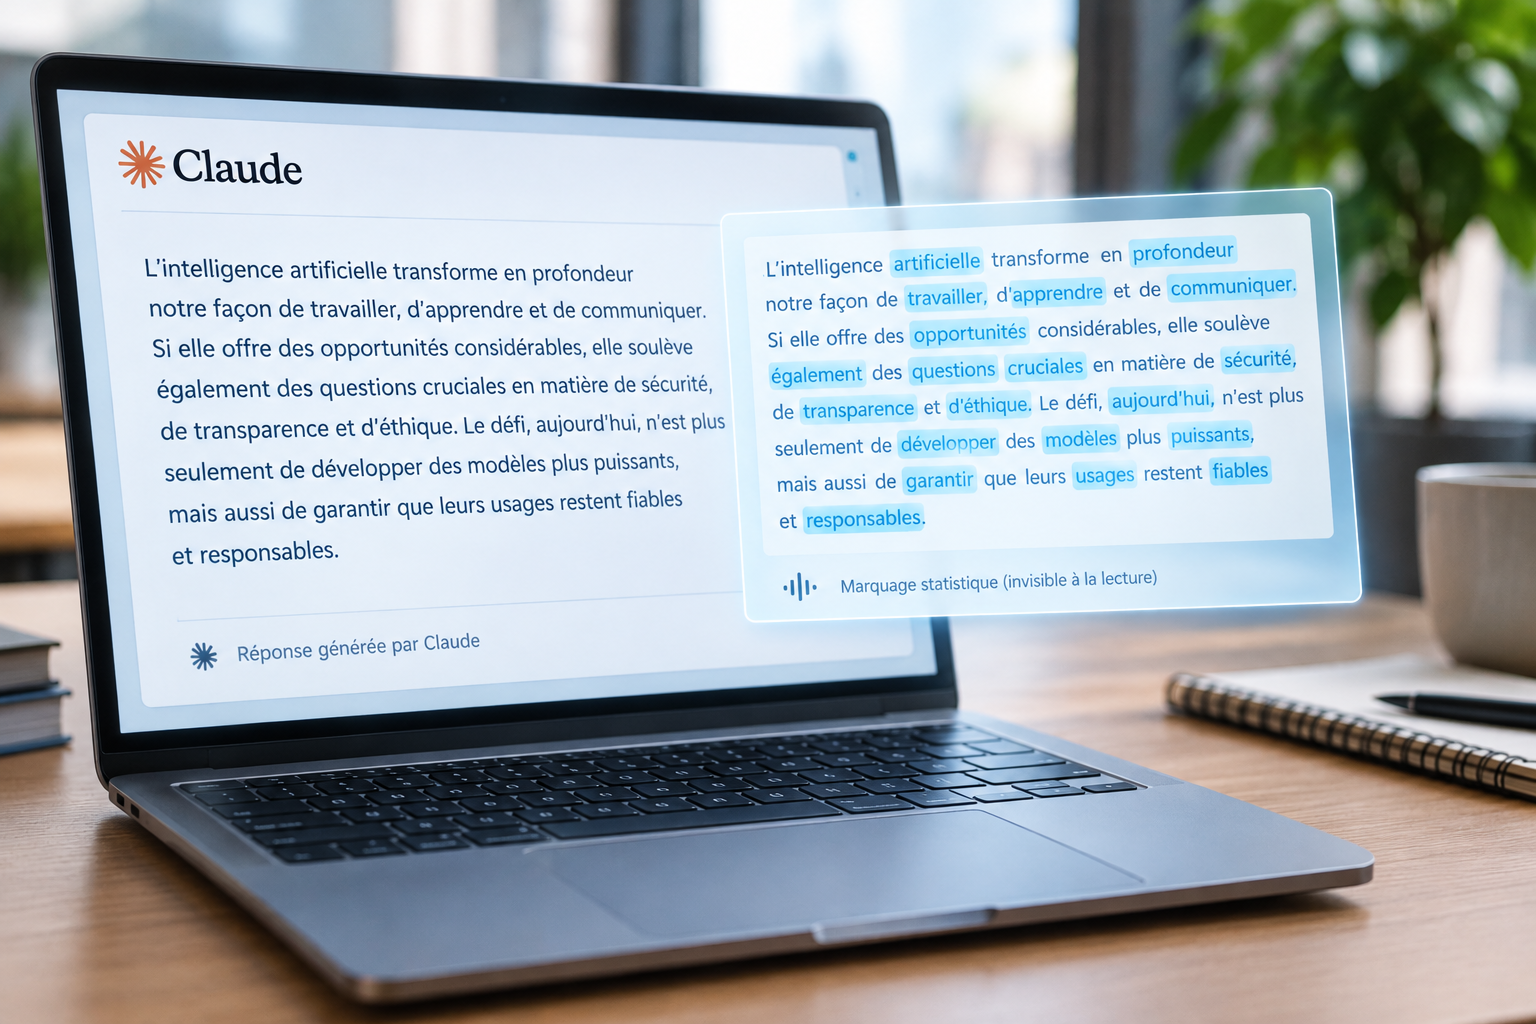
En matière d’intelligence artificielle, l’invisibilité est rarement un gage de sécurité. Alors que la génération de texte automatique atteint un niveau de persuasion inédit, la traçabilité des contenus générés par l’IA est devenue le nouveau nerf de la guerre. Face au risque de désinformation et de fraude académique, Anthropic mise sur une arme discrète mais techniquement redoutable : le filigrane textuel (watermarking). En insérant une signature mathématique indécelable à la lecture dans les réponses de Claude, l’entreprise promet d’authentifier la prose artificielle sans en altérer la qualité. Mais entre la théorie statistique et la réalité du terrain, où une simple reformulation peut suffire à tout effacer, la mesure interpelle. Innovation salvatrice pour la transparence du Web ou simple illusion de contrôle ? Pour le savoir, TNS a interrogé ChatGPT.
Comment fonctionne concrètement le filigrane textuel de Claude ? Est-ce une signature cachée dans les mots ?
« Pas exactement. Il ne s’agit ni d’un caractère Unicode invisible, ni d’une métadonnée qui disparaîtrait au premier copier-coller. Le filigrane est intégré au processus de génération : Claude modifie légèrement la manière dont il sélectionne certains mots parmi plusieurs formulations possibles. Pris isolément, chaque choix reste banal ; mais, sur un texte suffisamment long, l’ensemble peut produire une signature statistique repérable par un outil de détection. Anthropic affirme que ce marquage est imperceptible et qu’il ne modifie ni le sens, ni la qualité, ni la lisibilité des réponses.
Pour que cette signature statistique devienne réellement exploitable par un algorithme de détection, la réponse de Claude doit atteindre une certaine longueur, généralement entre 150 et 200 tokens, soit l’équivalent d’un court paragraphe. En deçà de ce seuil, la marge d’erreur statistique est trop importante pour affirmer quoi que ce soit. De même, ce filigrane s’avère presque inexistant sur du code informatique ou sur des listes de données brutes.
Cette technologie ne concerne toutefois pas nécessairement tous les modèles historiques de Claude. Anthropic indique que les modèles lancés à partir du 2 août 2026 prennent en charge ce marquage dès leur déploiement, tandis que l’adaptation des versions plus anciennes est encore en cours. Ce choix de calendrier ne doit rien au hasard : il s’aligne directement sur les exigences de l’EU AI Act, qui impose aux fournisseurs d’IA de marquer les contenus synthétiques de façon lisible par une machine. Le dispositif s’applique ainsi de manière uniforme, que l’accès à Claude se fasse par le site d’Anthropic, son API, ses outils de code ou ses déploiements cloud partenaires sur AWS, Google Cloud et Microsoft. » – ChatGPT
Un détecteur pourra-t-il prouver qu’un texte a été écrit par Claude ?
« Il pourra vraisemblablement établir qu’un texte est compatible avec une génération ou une transformation par Claude, mais pas prouver à lui seul que Claude en est l’auteur intégral. Anthropic précise que le marquage peut apparaître lorsqu’un utilisateur soumet un texte humain à Claude pour le corriger, le traduire, le reformuler ou le mettre en forme. Dans ce cas, le filigrane signalerait l’intervention du modèle, pas l’origine des idées ni l’identité de l’auteur.
La nuance est essentielle pour l’université, le journalisme ou le recrutement : un résultat positif ne devrait pas être traité comme une preuve automatique de fraude. Le texte peut être hybride, partiellement humain et partiellement généré ; il peut aussi avoir été réécrit après son passage dans Claude.
Pour les fichiers médias comme les images aux formats PNG, JPG ou SVG, le fonctionnement est d’ailleurs différent : Anthropic complète ce marquage textuel par le standard ouvert C2PA (Coalition for Content Provenance and Authenticity). Contrairement au filigrane statistique appliqué aux mots, il s’agit ici d’un certificat cryptographique gravé directement dans les métadonnées du fichier pour retracer son historique de création. » – ChatGPT
Le filigrane est-il une avancée décisive ou une simple illusion de contrôle ?
« C’est une avancée utile, mais certainement pas une solution miracle. Son intérêt est de fournir un signal de provenance directement attaché au texte, susceptible de voyager avec lui lors d’un copier-coller et de résister à certaines modifications légères. Cela peut aider les plateformes, les médias ou les institutions à documenter l’origine probable d’un contenu, dans un contexte où les textes générés deviennent de plus en plus difficiles à distinguer à l’œil nu.
Un autre élément clé réside dans le respect de la vie privée : la signature statistique injectée dans le texte reste totalement générique. Elle atteste l’intervention du modèle, mais ne contient aucune métadonnée personnelle, aucun identifiant d’utilisateur, de compte ou d’entreprise. Elle permet d’identifier l’outil, pas la personne qui l’a sollicité.
Mais tout filigrane textuel repose sur un compromis entre qualité, détectabilité et robustesse. Une réécriture complète, une traduction, un résumé ou une nouvelle génération par un autre modèle peuvent affaiblir ou faire disparaître le signal. À l’inverse, un texte humain simplement corrigé par Claude peut être marqué. Le filigrane doit donc être considéré comme un indice technique de provenance, et non comme un certificat d’auteur. La bonne question n’est pas : « Ce texte est-il artificiel ? », mais plutôt : « Dans quelle mesure un modèle d’IA a-t-il participé à sa production ? » C’est cette distinction qui décidera si le filigrane devient un outil de transparence, ou une nouvelle source de faux procès. » – ChatGPT
Les + vues
Inscrivez-vous !
INSCRIVEZ-VOUS À
NOTRE NEWSLETTER !
![]()
Renseignez votre adresse mail
pour recevoir nos nouveautés
et rester informé de nos actualités.
Top Mots Clés :
Laisser un commentaire